


Av Kjell Omdal Erichsen, Testify
I min forrige artikkel skrev jeg om hvordan kunstig intelligens kan redusere avstanden mellom det å identifisere et testproblem og det å ha et fungerende verktøy som løser det, gjennom å bygge testdatainjektorer, pseudonymiseringspipelines og diagnoseverktøy på timer, i stedet for å vente i ukevis på infrastruktur som kanskje aldri kommer.
Det handlet om å faktisk få gjennomført testingen av et system som i utgangspunktet er klart til test.
Men nylig støtte jeg på en vanskeligere variant av det samme problemet: Hva gjør du når du må verifisere en kompleks integrasjon mellom flere systemer, men integrasjonen i praksis ikke vil finnes før like før go-live?
Go-live-dilemmaet
Oppsettet var hentet rett fra klassisk virksomhetshverdag. En HR-dataintegrasjonstjeneste var utviklet for å publisere hendelser i de ansattes livssyklus til et Azure Service Bus-topic og eksponere et REST-API. På konsumentsiden hadde et eksternt konsulentteam skrevet plattformskript i ServiceNow for å konsumere meldingene, hente komplette synkroniseringer via REST-endepunktet, transformere dataene og oppdatere brukerposter.
Problemet var at hele kjeden ikke kunne kjøres i QA:
- Systemene var ikke synkroniserte. Inndata fra oppstrøms systemer og avhengigheter rundt dem var fortsatt ute av takt. Det betydde at ende-til-ende-miljøet ikke var tilgjengelig for tidlige utforskende kjøringer.
- Konsumenten var ikke vår. ServiceNow-skriptene var proprietær plattform-JavaScript skrevet av eksterne konsulenter. Vi kunne ikke koble til en debugger for å undersøke runtime-adferden i vårt eget miljø.
- Testtilfellene var tilstandsfulle sekvenser, ikke uavhengige kontroller. Testlederen hadde kartlagt scenarioer med flere steg. Hvis steg 2 i stillhet skrev en feil verdi til en brukerpost, ble steg 3 til 12 kjørt med feil utgangspunkt.
Den vanlige bransjeoppskriften i slike situasjoner er enkel: Vent til integrasjonsmiljøet stabiliserer seg, gjennomfør manuelle testdager sent i løpet, og prøv å sortere feil under go-live-press.
Vi bestemte oss for å ikke vente.
Strategien: Simuler produsenten, kjør den ekte konsumenten
Tankegangen var enkel: Simuler det du ikke har, og kjør den ekte koden du faktisk har.
Hvis vi hadde skrevet konsulentenes logikk på nytt i Python eller JavaScript, basert på hva vi trodde den gjorde, ville vi i realiteten bare ha testet vår egen tolkning. Alle subtile feil ville ha blitt jevnet ut av våre egne antakelser.
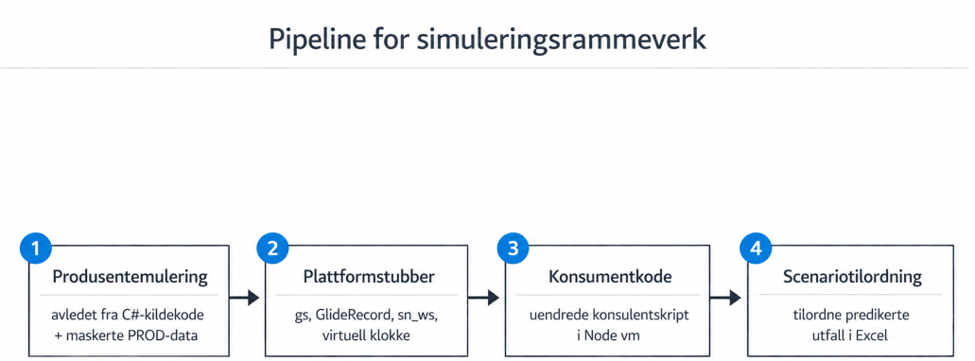
I stedet brukte jeg Claude til å bygge en lettvekts simuleringsrigg i Node.js, strukturert i fire tydelige stadier:
- Produsentemulering: En troverdig JavaScript-modell av backend-en til HR-dataintegrasjonstjenesten, hentet direkte fra den faktiske C#-kildekoden. Modellen gjenspeilte de nøyaktige serialiseringsinnstillingene, LINQ-filtrene, livssyklusbehandlerne og tidsvinduene for synlighet.
- Plattformstubber: En minimal shim for ServiceNow-runtime-API-et (gs.info/warn/error, GlideRecord-tabeller i minnet, sn_ws.RESTMessageV2 og importset-tabeller). Avgjørende var det at tid ble injisert via en virtuell klokke i stedet for at systemklokken ble lest. Dermed kunne vi deterministisk simulere gårsdagen, dagen i dag eller tre måneder frem i tid.
- Uendret konsumentkode: Vi lastet konsulentenes fire faktiske skriptfiler direkte inn i en Node.js virtuell-kontekst. Ingenting ble skrevet om, lappet eller tilpasset.
- Scenariomapping: Et skript som leste inn testlederens Excel-ark med scenarioer, kjørte stegene sekvensielt og skrev de forventede resultatene tilbake til arket.
Å utlede sannheten fra kildekoden, ikke dokumentasjonen
I den tidligere artikkelen viste jeg til Erik Arisholms idé om LLM-er som kompilatorer som oversetter spesifikasjoner. Her traff spesifikasjonsproblemet oss umiddelbart: Den offisielle dokumentasjonen og Swagger-filen var feil på punkter som hadde betydning.
Da jeg bygde produsentemulatoren sammen med Claude, tok vi ikke utgangspunkt i dokumentasjon. Vi hentet adferden direkte fra C#-kildekoden:
- Swagger-dokumentasjonen hevdet at en enum var et heltall på tvers av alle endepunkter. C#-kildekoden viste at den ble serialisert som et rått tall på Azure Service Bus (
JsonSerializer.Serializemed standardinnstillinger), men som en tekststreng («TEK«) over REST, på grunn av en globalJsonStringEnumConverter iProgram.cs. - REST-spørringens utvidelser viste at avsluttede arbeidsforhold forsvant fra standardvisningen etter én dag (today − 1), mens aktive poster fortsatt var synlige i 30 dager.
Ved å kode inn den faktiske C#-logikken i JavaScript-simuleringen, i stedet for å stole på API-dokumentasjonen, gjenskapte simuleringsriggen det backend-systemet faktisk ville sende ut over linjen.
Hvorfor vi trengte morgendagens data
En simulator er bare så god som dataene du mater den med. Håndlagde syntetiske testsett er utmerkede for å sjekke bestemte sammenhenger, utforskende og systematisk, men de har praktiske svakheter: Du tester bare de tilfellene du har tenkt på å konstruere.
Heldigvis hadde vi en annen kritisk ressurs: maskerte testdata basert på produksjonsdata.
På grunn av blokkeringer i omkringliggende systemer var dette maskerte datasettet ennå ikke lastet inn i QA-instansen til HR-dataintegrasjonstjenesten. Men vi hadde filene. Og fordi pseudonymiseringspipen vår bevarte dataformater og relasjonsnøkler på tvers av entiteter, kunne vi mate dette realistiske datasettet direkte inn i den simulerte HR-dataintegrasjonstjenesten.
Det ga oss det beste fra to verdener:
- Syntetiske testdatabyggere for presis enhetstestkontroll over spesifikke randtilfeller, som kompliserte ansattforhold med flere stillinger, tilbakevirkende forfremmelser og flere samtidige arbeidsforhold.
- Maskerte produksjonsdata – data for omtrent 7000 ansatte – som kunne avdekke virkelige fordelinger, avvik knyttet til flere roller og uventede verdier i gamle felter før utrulling.
Hva den ekte koden avdekket
Fordi vi kjørte konsulentenes uendrede kode mot realistiske datastrukturer og simulert tid, avdekket vi strukturelle problemer som kodegjennomganger ikke hadde fanget opp:
1. En feil på ett tegn med stor effekt
Konsulentenes fullsynkroniseringsskript filtrerte poster med type === 'Private', mens API-et faktisk sendte ut «private» med liten forbokstav. Resultatet var at feltet for sekundær e-postadresse var fullstendig tomt for alle poster under fullsynkronisering, samtidig som det fungerte helt fint i hendelsesstrømmen. Det var først da vi kjørte begge løpene mot den faktiske serialiseringen, at feilen ble synlig.
2. Tidsavhengige hull i synligheten
Fordi avsluttede arbeidsforhold forsvant fra standardvisningen i REST etter 24 timer, mottok en konsument som hentet data fra API-et én dag for sent, en post med tomme ansettelsesdatoer. Den virtuelle klokken gjorde dette synlig umiddelbart.
3. «Slett før opprett» ved sammenhengende arbeidsforhold
I et scenario med flere steg, knyttet til overgang mellom kontrakter, sendte den nattlige avstemmingsjobben ut en Deleted-hendelse morgenen dag 3, etterfulgt av en Inserted-hendelse for den nye stillingen senere samme ettermiddag. På papiret så dette ut som en ryddig overgang. I konsumentens tilstandsmaskin utløste det imidlertid uventet deaktivering av kontoer for en ansatt som aldri faktisk hadde sluttet.
«Pre-bug»-problemet: Å argumentere for en feil som ennå ikke har skjedd
Den mest krevende oppdagelsen testriggen produserte var ingen programmeringsfeil i noens kode. Det var en grunnleggende misforståelse om hvilken identifikator et felt faktisk inneholder. Oppfatningen var delt av et kompetent team, støttet av alle data de noensinne hadde observert, og som kun tok feil om fremtiden.
I filmen Minority Report arresterer politiet folk for forbrytelser de kommer til å begå. Dette var en «pre-bug» – en feil vi rapporterte før den hadde feilet en eneste gang i praksis.
Hva som skjedde
Organisasjons-systemet bygger organisasjonstreet for ServiceNow ved å lese /api/v1/persons og koble hver persons managerId sammen med lederens personId. Ansvarlige for Organisasjons-systemet rapporterte at dette fungerte utmerket: Begge feltene inneholdt 10-sifrede tall, og oppslaget hadde aldri feilet i test eller drift. Alt dette stemte med virkeligheten.
Men det som også var sant, var at personId stammet fra den eldre databasens nummerserie, mens managerId kom fra HR-systemet. Det var to ulike systemer og to ulike datakilder, koblet sammen av et rent historisk sammentreff.
Hvorfor ordinære tester ikke kunne finne feilen
Vanligvis kjører man konsumentens kode mot produsenten og observerer hva som skjer. Det fungerte ikke her, fordi dagens data inneholdt nøyaktig det sammentreffet som maskerte feilen. Målt over hele det maskerte datasettet var statusen entydig:
- Rader der eldre database-ID == HR-system-ID: 7804
- Rader der ID-ene var ulike: 0
- Leder-ID-er som slo opp mot eldre database: 91 / 91
- Leder-ID-er som slo opp mot HR-systemet: 91 / 91
Hver eneste leder-ID slo opp i begge populasjonene, fordi de to nummerseriene var identiske rad for rad i historiske data. Observasjonen om at «dette fungerer, og begge er 10 siffer» passet like godt med hypotesen om at feltene var samme identifikator, som med hypotesen om at HR-systemet tilfeldigvis hadde gjenbrukt samme tallserie i en overgangsperiode. Dataene kunne ikke skille mellom forklaringene og dette var de eneste dataene konsument-teamet hadde sett.
En test mot reelle produksjonsdata ville ha passert med glans. En test mot pseudonymiserte data ville også ha passert, fordi god pseudonymisering bevarer formater og referanseintegritet. Sammentreffet ble bevart uforstyrret.
Hva simulatoren ble brukt til
For å løse dette gjorde vi to grep i en bevisst rekkefølge:
Først kvantifiserte vi sammentreffet: 7804 av 7804. Det å anerkjenne teamets observasjon med harde tall flyttet samtalen fra «dere tar feil» til «dataene dere sitter på kan umulig avgjøre dette spørsmålet».
Deretter konstruerte vi tilstanden som den virkelige verden ennå ikke hadde nådd. HR-systemet begynte å tildele ansattnumre fra en ny 900000-serie, mens den eldre databasen fortsatte å dele ut sine tradisjonelle 10-sifrede identifikatorer. En leder ansatt etter dette tidspunktet ville være den første personen der de to ID-ene genuint skilte lag. Vi injiserte dette tilfellet i testriggen:
- Leder ansatt i 2019: HR-system=0018575400 Eldre database=0018575400 -> MATCHER
- Leder ansatt i 2026: HR-system=900160 Eldre database=1147203000 -> FINNER INGENTING
Ingen feilmeldinger og ingen advarsler i loggen. Oppslaget returnerte simpelthen ingenting, den ansatte så ut til å stå uten leder, og organisasjonstreet begynte i det stille å mangle grener.
Det som til slutt avgjorde saken var verken simuleringen eller dataene i seg selv, men kildekoden. To linjer viste at feltene ble hentet fra to vidt forskjellige kildeattributter i HR-systemet og den eldre databasen. Simuleringen kunne ikke bevise sannheten alene, men den illustrerte konsekvensen så tydelig at det var verdt tiden for en utvikler å sjekke disse kodelinjene.
Tydelighet omkring hva som ikke er testet
En simulering som påstår å dekke alt, har liten troverdighet. For at både prosjektledelsen og de eksterne konsulentene skulle stole på funnene våre, var vi tydelige på hva testriggen bevisst utelot:
- Infrastruktursemantikk: Vi modellerte ikke partisjoneringsrekkefølge i Azure Service Bus, nettverk-feil, utløpte tokens eller dead-letter-køer.
- Interne mekanismer i Brukerportal-systemet: Vi simulerte ikke reelle transform-maps, komplekse tilgangskontroller (ACL) eller plattformens forretningsregler.
- Bakenforliggende forretningslogikk: Vi startet ved inngangsgrensen til HR-dataintegrasjonstjenesten, og simulerte ikke kjernesystemene bakenfor direkte.
Ved å være eksplisitt på disse begrensningene, ble funnene våre mindre omstridte og ble vurdert som en verdifull sjekkliste før produksjonssetting. Og i rapporten konsulentene mottok leste de ikke bare teoretiske vurderinger, men konsollogger og tilstandstabeller generert av deres egne umodifiserte skript.
Test med flerdoblet slagkraft ved hjelp av KI
Å sette opp hele denne testriggen – simulatoren, stubbene, testkjørerne og eksporten til testlederens regneark – tok under tre timer i tett samspill med Claude, for første fungerende versjon.
Å bygge noe slikt fra bunnen av for hånd ville historisk sett vært umulig å forsvare. Det ville tatt lengre tid enn det vi hadde til rådighet i denne fasen, å stubbe plattformen, skrive serialisererne og kode testkjørerne.
Kunstig intelligens endrer økonomien i testfaget:
- Mekaniske oppgaver blir forbruksvare: Å skrive 200 linjer med stubs for et eksternt API har gått fra å være et dagsverk til å være en kort, samtalebasert oppgave.
- Ansvaret for testarkitekturen ligger fortsatt hos testeren: Beslutningen om å kjøre umodifisert kode i et isolert virtuelt-miljø, håndheve deterministisk tid, identifisere autoritative kildekodefiler og designe kumulative flerstegstester, er ingeniørmessige vurderinger som krever menneskelig ekspertise.
En ny virkelighet for tidligst mulig testing
Test tidligst mulig, kjent som «Shift Left», innebærer å teste så tidlig i utviklingsløpet som mulig, for å unngå at testing og påfølgende feilretting skjer lenger ut mot sluttbrukerne som vil koste mange ganger mer utviklings- og oppfølgingstid, enn om utvikler selv finner feilen mens koden lages.
I komplekse integrasjonslandskap innebærer «Shift Left» å ikke la fraværet av et komplett testmiljø hindre deg i å undersøke systemets faktiske oppførsel.
Ved å kombinere produsentens kildekode, konsumentens umodifiserte logikk, maskerte produksjonsdata og verktøybygging med KI, kunne vi forutse hvordan integrasjonen ville oppføre seg lenge før en eneste kodelinje møttes i testmiljøet. Og da den formelle testperioden startet, slapp teamet å famle i blinde. De kunne verifisere det vi allerede visste, og konsentrere testingen rundt det simuleringen bevisst utelot.
Kjell Omdal Erichsen er senior testingeniør i Testify AS, med spesialisering innen teknisk testautomatisering, integrasjonsarkitektur og praktisk bruk av AI-verktøy for utviklings- og testmiljøer.
Tilbake til blogg